Съдържание на статията
Накратко: Невронната мрежа е програма от прости изчислителни възли, наречени неврони, подредени на слоеве. Всеки неврон умножава входовете си по числа, наречени тегла, събира ги и подава резултата нататък. Мрежата се учи, като сама поправя теглата си след всяка грешка, отново и отново. Така работят разпознаването на лица, автоматичният превод и ChatGPT.
Ключови факти:
- В изкуствената невронна мрежа невроните на мозъка са представени от възли с числови стойности, а синапсите от връзки, които стават по-силни или по-слаби (Кралската шведска академия на науките)
- Курсът CS231n на Станфорд нарича изкуствения неврон „много груб“ модел на биологичния: той само умножава входовете по теглата, добавя отместване и прилага активационна функция (Stanford CS231n)
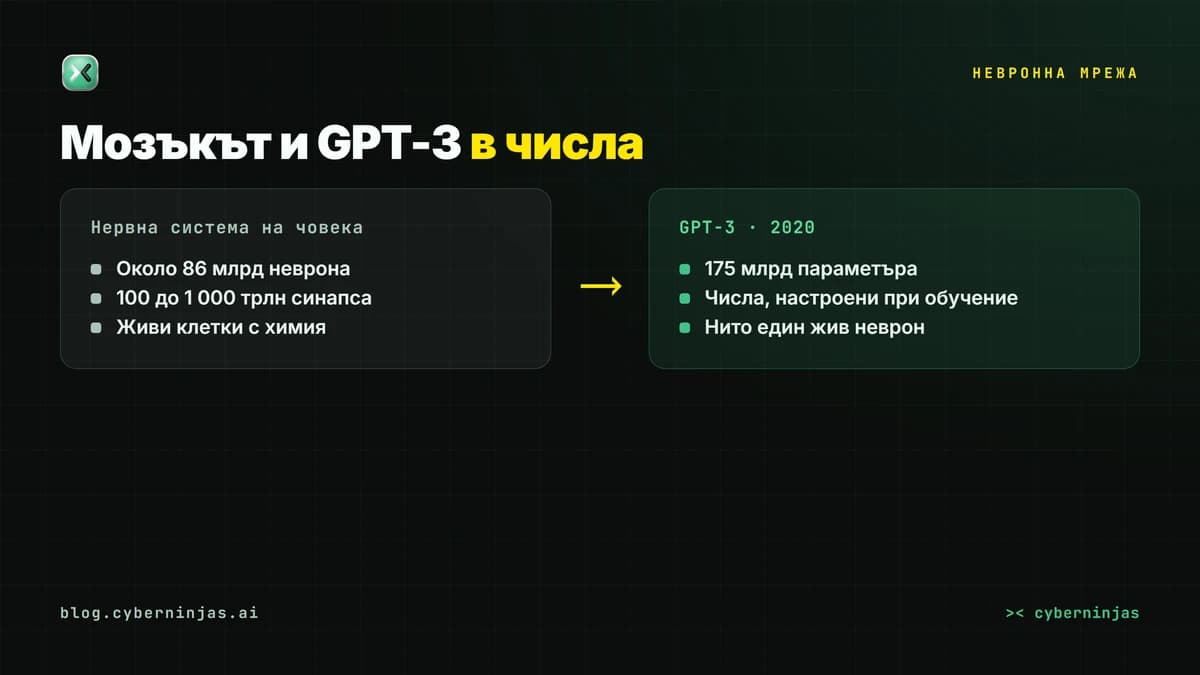
- Човешката нервна система има около 86 милиарда неврона и между 100 и 1 000 трилиона синапса (Stanford CS231n)
- GPT-3 от 2020 г. има 175 милиарда параметъра, 10 пъти повече от всеки предишен плътен езиков модел (arXiv)
- На 8 октомври 2024 г. Нобеловата награда за физика отиде при Джон Хопфийлд и Джефри Хинтън за открития, които правят възможно машинното обучение с изкуствени невронни мрежи (Кралската шведска академия на науките)
- През юли 1958 г. перцептронът на Франк Розенблат се научава след 50 опита да различава перфокарти с белег вляво от карти с белег вдясно (Cornell Chronicle)
- Невидима промяна в снимка на панда кара мрежата GoogLeNet да я обяви за гибон с 99,3% увереност (arXiv, Goodfellow и др.)
- BgGPT на института INSAIT в София е обучен върху около 85 милиарда токена текст на български (Google DeepMind)
Какво е невронна мрежа?
Невронната мрежа (на английски neural network) е програма, която се учи от примери, вместо да изпълнява правила, написани от човек. Курсът по машинно обучение на Google я определя като семейство модели, създадени да откриват нелинейни закономерности в данните (Google for Developers). Авторите на учебната площадка TensorFlow Playground го казват още по-кратко: това е начин да се направи компютърна програма, която се учи от данни (TensorFlow Playground).
„Нелинейни“ звучи страшно, а значи нещо просто. Ако цената на апартамента растеше точно с квадратурата, една права линия щеше да стига, за да я предскажете. Светът рядко е толкова прав. Котката на снимката може да е вляво или вдясно, на светло или на тъмно, седнала или легнала. Една формула не може да опише всички тези случаи. Невронната мрежа може, защото е сглобена от хиляди прости части, които заедно огъват линията точно там, където трябва.
Кралската шведска академия на науките пише, че когато говорим за изкуствен интелект, често имаме предвид машинно обучение с изкуствени невронни мрежи (Кралската шведска академия на науките). Разпознаването на лица, преводът на страница и чатботовете стъпват на тази идея. Широката картина с всички видове AI сме подредили в статията какво е изкуствен интелект, обяснено без формули.
В търсачката хората пишат и „неврона мрежа“, и „неврална мрежа“. Второто е буквален превод на английското neural network. Тук пишем „невронна мрежа“, от „неврон“, но и трите изписвания търсят едно и също нещо.
Има ли невронната мрежа истински неврони?
Няма. Тук е голямото недоразумение около невронните мрежи. Името подсказва мозък, а вътре няма нито една жива клетка. Има числа.
Кралската шведска академия на науките, която връчва Нобеловата награда за физика, го описва така: в изкуствената невронна мрежа невроните на мозъка са представени от възли с различни стойности, а връзките между тях могат да се сравнят със синапси, които стават по-силни или по-слаби (Кралската шведска академия на науките). Важната дума е „представени“. Възелът не е неврон. Той е място в паметта на компютъра, в което стои едно число.
Курсът CS231n на Станфордския университет е още по-ясен. Там пише, че този модел на биологичния неврон е много груб (Stanford CS231n). Истинският неврон е жива клетка с химия, електричество и хиляди връзки. Изкуственият е една сметка: умножение, събиране и решение какво да подаде нататък.
Учебникът „Deep Learning“ на Иън Гудфелоу, Йошуа Бенджио и Арън Курвил, издаден от MIT Press през 2016 г. и свободен за четене онлайн, го казва директно:
„Невронните мрежи, които се ползват в машинното обучение, по принцип не са проектирани да бъдат реалистични модели на биологичната функция.“ Иън Гудфелоу, Йошуа Бенджио и Арън Курвил, авторите на учебника „Deep Learning“ (MIT Press)
Мозъкът е дал идеята, но мрежата не го копира. Самолетът също е вдъхновен от птиците, но не маха с крила.
Това има практическа страна. Когато някой ви продава програма, която „мисли като човешки мозък“, той ви продава метафора. Под нея стоят милиарди числа, които никой не е писал на ръка.
От какво е направена невронната мрежа: неврон, тегло, слой?
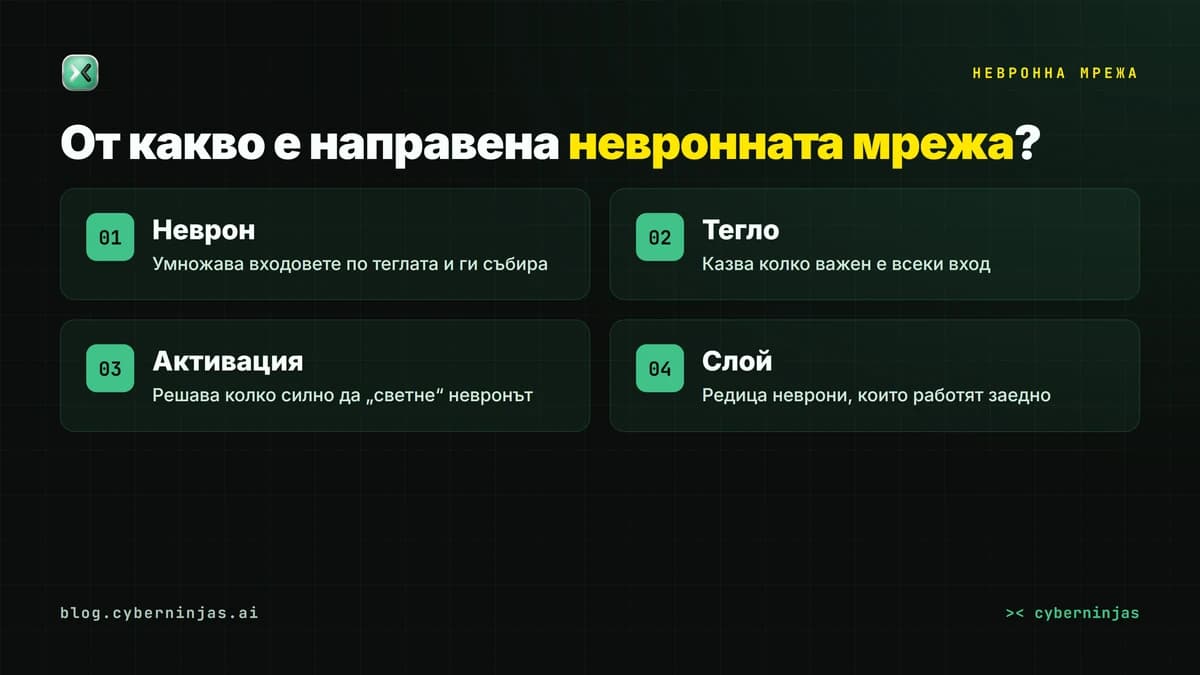
Всяка невронна мрежа, от най-малката до тази зад ChatGPT, е сглобена от едни и същи четири части.
Невронът е най-малката част. Получава няколко числа на входа, умножава всяко по неговото тегло, събира резултатите, добавя още едно число, наречено отместване, и прекарва сумата през проста функция (Stanford CS231n).
Теглото казва колко важен е даден вход. Представете си, че решавате дали да вземете чадър. Входовете са облаците, прогнозата за времето и дали ще пътувате с кола. Ако прогнозата е най-важна за вас, тя получава голямо тегло. Колата намалява нуждата от чадър, значи нейното тегло е отрицателно. Мрежата прави същото, само че с хиляди или милиарди входове и без да знае какво означават.
Активационната функция е решението накрая. Тя казва на неврона колко силно да „светне“. Без нея цялата мрежа, колкото и голяма да е, щеше да чертае само прави линии. Курсът на Google показва точно това: една линейна функция не може да отдели чисто сините точки от оранжевите, когато те не лежат от двете страни на права линия (Google for Developers).
Слоят е редица неврони, които работят едновременно. Първият слой получава данните, например пикселите на една снимка. Последният дава отговора, например „котка“ или „куче“. Слоевете между тях се наричат скрити, защото не се виждат отвън.
Колко могат тези прости части, показва едно математическо свойство. Курсът на Станфорд отбелязва, че мрежа с поне един скрит слой е универсален апроксиматор (Stanford CS231n). С прости думи, при достатъчно неврони тя може да се доближи до всяка непрекъсната зависимост в данните.
Как работи невронната мрежа, когато ѝ дадете задача?
Да вземем снимка, на която трябва да се познае човек. За компютъра снимката е таблица от числа: колко червено, зелено и синьо има във всяка точка.
Числата влизат в първия слой. Всеки неврон там прави своята малка сметка и подава резултата към всички неврони в следващия слой. Те правят своята сметка и подават нататък. Накрая последният слой дава отговор, например „човек: 94%“.
Учебникът на Гудфелоу, Бенджио и Курвил обяснява какво става по пътя. Мрежата сглобява сложното понятие „човек“ от по-прости понятия като ъгли и контури, които от своя страна са изградени от ръбове (Deep Learning, глава 1). Никой не е казал на мрежата какво е ръб или ъгъл. Тя сама е стигнала до тях, защото така отговорите ѝ стават по-точни.
В този момент мрежата не се учи. Тя само прилага наученото. Сметките текат в една посока, от входа към изхода. Затова този вид се нарича мрежа с право разпространение (feedforward), а класическият ѝ пример е многослойният перцептрон (Deep Learning, глава 1).
Как се учи невронната мрежа?
В ученето няма магия. Представете си, че настройвате радио с милиони копчета в тъмна стая. Не знаете кое копче какво прави. Имате само един сигнал: колко силно пращи.
Мрежата прави точно това, на четири стъпки.
- Започва с произволни тегла. В началото отговорите ѝ са пълна случайност.
- Познава и мери грешката. Показват ѝ пример, за който верният отговор е известен, например снимка с надпис „котка“. Тя дава своя отговор, а една формула пресмята колко далеч е от верния.
- Разбира кое копче е виновно. Методът се нарича обратно разпространение на грешката (backpropagation). Курсът CS231n го описва като начин да се пресметнат градиентите, тоест наклоните, чрез повторно прилагане на верижното правило от математиката (Stanford CS231n). Важното за вас е резултатът: за всяко тегло мрежата научава в каква посока да го завърти, за да намалее грешката.
- Завърта всички копчета съвсем малко и повтаря. Една стъпка не променя почти нищо. Милиони стъпки променят всичко.
Методът не е нов. През октомври 1986 г. Дейвид Румелхарт, Джефри Хинтън и Роналд Уилямс публикуват в списание Nature статията „Learning representations by back-propagating errors“ (Nature). Учебникът „Deep Learning“ отбелязва, че към 2016 г. обратното разпространение остава основният начин за обучение на дълбоки модели (Deep Learning, глава 1).
Колко голямо може да стане това, показва 2012 г. Алекс Крижевски, Иля Суцкевер и Джефри Хинтън обучават мрежа с 60 милиона параметъра и 650 000 неврона върху 1,2 милиона снимки. На състезанието ImageNet тя трябва да постави верния отговор сред първите си пет предположения. Грешката ѝ е 15,3% при 26,2% за втория участник (NeurIPS, 2012).
Защо дълбоката невронна мрежа се нарича „дълбоко“ обучение?
Думата „дълбоко“ описва броя на слоевете. За дълбочината на мисълта тя не казва нищо.
Учебникът „Deep Learning“ го обяснява с картина. Ако начертаете как понятията в мрежата са построени едно върху друго, графиката е дълбока, с много слоеве. Затова този подход се нарича дълбоко обучение (Deep Learning, глава 1).
Същият учебник разделя историята на невронните мрежи на три вълни:
- 1940-те до 1960-те: първите теории за биологичното учене и първите модели, включително перцептронът от 1958 г., който обучава един-единствен неврон.
- 1980 до 1995 г.: обратното разпространение прави възможно обучението на мрежи с един или два скрити слоя.
- От около 2006 г.: дълбокото обучение, с много слоеве, много данни и бързи компютри.
Едно число показва колко далеч са мрежите от мозъка. Според учебника изкуствените невронни мрежи са удвоявали размера си приблизително на всеки 2,4 години. Авторите пишат, че при това темпо те няма да имат толкова неврони, колкото човешкият мозък, поне до 2050-те години (Deep Learning, глава 1).
Сметката е лесна за проверка. Мрежата от 2012 г. има 650 000 неврона. Човешката нервна система има около 86 милиарда. Това е около 130 000 пъти повече.
Каква е връзката между невронната мрежа и ChatGPT?
Зад ChatGPT стои невронна мрежа. Много голяма и с особено устройство, но невронна мрежа.
През юни 2017 г. осем изследователи публикуват статията „Attention Is All You Need“. В нея представят архитектурата Transformer, която разчита само на механизма на вниманието, без по-старите рекурентни и конволюционни слоеве (arXiv). Буквата „T“ в GPT идва оттам. Вниманието позволява на мрежата да свърже всяка дума в текста с всяка друга, дори когато са далеч една от друга.
Три години по-късно OpenAI описва GPT-3: езиков модел със 175 милиарда параметъра (arXiv). Параметрите са точно теглата, за които говорихме, копчетата на радиото. Мрежата ги е настроила, докато се е учила да предсказва следващата дума в огромни количества текст. Как от това предсказване се получава цял отговор, обясняваме в статията за изкуствения интелект.
175 милиарда звучи като мозък. Сравнението е грубо, защото параметърът не е синапс, но е полезно. Човешката нервна система има между 100 и 1 000 трилиона синапса (Stanford CS231n). Ако разделите това на 175 милиарда, излиза, че синапсите са между около 570 и 5 700 пъти повече от параметрите на GPT-3.
Ако ползвате чатбот, помнете това: моделът е огромна таблица от числа, настроени върху текстове. Той не помни разговори от вчера, ако системата не му ги подаде, и не проверява фактите си сам. Кой от големите асистенти за какво е най-добър, сме сравнили в ChatGPT срещу Claude срещу Gemini.
Кой измисли невронната мрежа и защо идеята ѝ беше отписана?
През юли 1958 г. Службата за военноморски изследвания на САЩ показва изобретението на Франк Розенблат, психолог и инженер в Корнелската аеронавтична лаборатория. На компютър IBM 704, машина от 5 тона с размерите на стая, подават поредица перфокарти. След 50 опита компютърът сам се научава да различава картите с белег вляво от картите с белег вдясно (Cornell Chronicle).
Програмата се казва перцептрон. Корнел днес я нарича първата невронна мрежа. Розенблат я описва като първата машина, способна да има оригинална идея. Вестник „Ню Йорк Таймс“ излиза със заглавие: „Ново устройство на флота се учи, като върши. Психолог показва зародиш на компютър, създаден да чете и да умнее“ (Cornell Chronicle).
Обещанията изпреварват машината. През 1969 г. Марвин Мински и Сиймур Пейпърт издават книгата „Perceptrons“. Корнел пише, че тя атакува работата на Розенблат и практически решава съдбата ѝ. Според професор Торстен Йоахимс от Корнел Мински твърди, че функциите на перцептрона са твърде прости. Спадовете около перцептрона помагат да настъпи т.нар. „зима на AI“, години с рязко намалено държавно финансиране за изкуствения интелект (Cornell Chronicle).
Розенблат не доживява обрата. През 1971 г., на своя 43-ти рожден ден, той се удавя, докато плава с лодка в залива Чесапийк. Статията на Корнел за него е озаглавена „Перцептронът на професора проправи пътя на AI 60 години твърде рано“.
Обратът идва бавно. През 1986 г. Джефри Хинтън е сред авторите, които популяризират обратното разпространение. През 2012 г. е съавтор на мрежата, която печели ImageNet. На 8 октомври 2024 г. той и Джон Хопфийлд получават Нобеловата награда за физика за открития и изобретения, които правят възможно машинното обучение с изкуствени невронни мрежи (Кралската шведска академия на науките). Между книгата, която отписва перцептрона, и Нобеловата награда за невронните мрежи минават 55 години.
Защо невронната мрежа греши толкова уверено?
Защото увереността ѝ е само число. Три проверени примера го показват по-добре от всяка теория.
Пандата, която стана гибон. През 2014 г. Иън Гудфелоу и колегите му показват снимка на панда на мрежата GoogLeNet. Тя казва „панда“ с 57,7% увереност. После към снимката добавят толкова малка промяна, че човешкото око не я вижда. Мрежата вече казва „гибон“ с 99,3% увереност (arXiv, Goodfellow и др.). Грешният отговор излиза по-сигурен от верния.
Знакът „Стоп“ със стикери. В изследване, прието на конференцията CVPR през 2018 г., учени лепят само черни и бели стикери върху истински знак „Стоп“. В лабораторията мрежата бърка знака в 100% от снимките. В тест с камера в движеща се кола бърка в 84,8% от кадрите (arXiv, Eykholt и др.). Става дума за опит на учени. Той показва колко лесно се заблуждава мрежа, която гледа пътя.
Черната кутия. Самите създатели на големите модели признават, че не ги разбират докрай. През май 2024 г. Anthropic пише, че обикновено третира AI моделите като черна кутия. Погледнеш ли вътре, виждаш дълъг списък от числа без ясен смисъл. Изследователите успяват да извадят милиони понятия от модела Claude 3 Sonnet. Едно от тях отговаря на моста „Голдън Гейт“. Когато го усилват изкуствено, моделът на практика се вманиачава по моста (Anthropic).
Същото се случва и с текста. Чатботът дава гладко, уверено изречение, а фактът вътре може да е измислен. Подробно сме разгледали как да се пазите в защо AI греши и как да се предпазите.
Какви видове невронни мрежи има?
Основната идея е една, а устройствата са много. Ето най-известните и за какво служат.
| Вид мрежа | За какво служи | Пример |
|---|---|---|
| Перцептрон | Един неврон, прост отговор да или не | Машината на Розенблат, 1958 г. |
| Многослойна мрежа | Прогнози и класификация на данни | Класическата права мрежа с няколко слоя |
| Конволюционна мрежа | Снимки и видео | AlexNet, 2012 г., GoogLeNet |
| Рекурентна мрежа | Поредици като реч и текст | Ранните системи за разпознаване на реч |
| Трансформър | Текст, код, превод, разговор | ChatGPT, Claude, Gemini, BgGPT |
| Мрежа на Хопфийлд | Пази и възстановява образи | Откритието с Нобел за 2024 г. |
- ✓Учи се от примери, без някой да пише правилата ред по ред
- ✓Работи там, където ръчните правила са безсилни: лица, реч, превод
- ✓Една архитектура върши много задачи, от текст до код
- ✓По-големите мрежи с повече данни решават по-сложни задачи
- ✓През 2012 г. спечели ImageNet с 15,3% грешка срещу 26,2% за втория
- ×Никой не може да обясни напълно защо дава точно този отговор
- ×Невидима промяна в данните може да я заблуди напълно
- ×Звучи еднакво уверено, когато е права и когато греши
- ×Иска огромни количества данни и изчисления
- ×Намира закономерности в числа, без да разбира света
Има ли българска невронна мрежа?
Да. Най-известната е BgGPT, езиков модел на института INSAIT, основан през 2022 г. в София. Google DeepMind описва INSAIT като изследователска организация от световна класа (Google DeepMind).
Ето какво пише Google за първото поколение на модела:
- Основа: BgGPT стъпва на отворените модели Gemma 2 на Google.
- Размери: три версии с 27, 9 и 2 милиарда параметъра. Тоест 27 милиарда „копчета“ при най-голямата.
- Данни: обучен е върху около 85 милиарда токена на български и 15 милиарда на английски. Токенът е дума или част от дума.
- Резултат: според Google версиите с 27 и 9 милиарда параметъра изпреварват на български по-големи модели като Qwen 2.5 72B на Alibaba и Llama 3.1 70B на Meta.
- Употреба: от пускането си през март 2024 г. BgGPT.ai е отговорил на милиони въпроси на потребители (Google DeepMind).
Според Google модел с 27 милиарда параметъра изпреварва на български модели със 70 милиарда. Размерът е само едно от нещата, които решават. Другото е върху какви данни е учила мрежата, а BgGPT е учил върху 85 милиарда токена на български. Какво може новото поколение, BgGPT 3.0, сме описали в отделна статия.
Как да видите невронна мрежа с очите си стъпка по стъпка?
Не ви трябват формули, видеокарта или скъп софтуер. Трябват ви 20 минути и браузър.
Стъпка 1: Отворете TensorFlow Playground
Какво правим: пускаме истинска малка невронна мрежа в браузъра.
Как: отворете playground.tensorflow.org. Площадката е направена от Даниел Смилков и Шан Картър и започва с думите „Не се притеснявайте, не можете да я счупите“. В раздела DATA изберете един от наборите с оранжеви и сини точки. Натиснете бутона за пускане.
Очакван резултат: фонът постепенно се оцветява в оранжево и синьо, така че да огради точките. Числото Test loss, грешката на мрежата, пада. Дебелината на линиите между невроните показва теглата: синьото е положително, оранжевото е отрицателно.
Ако не работи: ако грешката не пада, проверете полето Activation. При Linear мрежата може да чертае само прави линии. Сменете на Tanh или ReLU.
Стъпка 2: Махнете скритите слоеве и вижте какво се чупи
Какво правим: доказваме си, че слоевете са важни.
Как: с бутона минус махнете всички скрити слоеве. Пуснете отново върху набор, в който точките не се разделят с права линия.
Очакван резултат: мрежата успява да начертае само права граница и грешката остава висока. Върнете два слоя по четири неврона и я пуснете пак. Границата се огъва и грешката пада.
Ако не работи: изберете друг набор. При някои набори точките се делят с права линия и разликата не се вижда.
Стъпка 3: Пуснете един неврон на Python
Какво правим: пишем перцептрон в 20 реда, същата идея като машината на Розенблат.
Как: копирайте кода в инсталиран Python 3 или в онлайн среда за Python и го пуснете.
# Един изкуствен неврон, който се учи да различава
# карта с белег вляво (отговор 1) от карта с белег вдясно (отговор 0).
cards = [([1, 0], 1), ([0, 1], 0)]

w = [0.0, 0.0]  # теглата: колко важен е всеки вход
b = 0.0         # отместването
lr = 0.1        # колко силно се поправя след грешка

for attempt in range(1, 11):
    mistakes = 0
    for x, correct in cards:
        total = x[0] * w[0] + x[1] * w[1] + b
        answer = 1 if total > 0 else 0
        error = correct - answer
        if error != 0:
            mistakes += 1
        w[0] += lr * error * x[0]
        w[1] += lr * error * x[1]
        b += lr * error
    print("Опит", attempt, "грешки:", mistakes)
    if mistakes == 0:
        break

print("Тегла:", [round(v, 2) for v in w], "отместване:", round(b, 2))
Очакван резултат: пуснахме кода, преди да го публикуваме. Той отпечатва „Опит 1 грешки: 2“, после „Опит 2 грешки: 0“ и накрая „Тегла: [0.1, -0.1] отместване: 0.0“. Невронът е научил, че белегът вляво „тежи“ в полза на отговор 1, а белегът вдясно го дърпа надолу. Машината от 1958 г. е имала нужда от 50 опита с истински перфокарти. Нашият пример е опростен до два входа, затова стигат два опита.
Ако не работи: ако Python спре с грешка за кодировка (UnicodeEncodeError), сменете българските думи в редовете с print с латински. Сметките остават същите.
Стъпка 4: Накарайте чатбота да ви изпита
Какво правим: проверяваме дали сме разбрали прочетеното.
Как: поставете това в ChatGPT, Claude, Gemini или BgGPT:
Ти си търпелив преподавател по машинно обучение.
Задай ми 5 въпроса, един по един, за това как работи невронната мрежа:
неврон, тегла, активационна функция, слоеве и обратно разпространение.
След всеки мой отговор кажи какво е вярно, какво не е и защо.
Не ми давай отговора, преди да съм опитал.
Очакван резултат: кратък изпит, който показва къде имате празнини.
Ако не работи: ако чатботът изсипе всички въпроси наведнъж, напишете му „Само първия въпрос“.
Стъпка 5: Хванете уверена грешка
Какво правим: виждаме със собствените си очи, че увереността не е доказателство.
Как: поискайте от чатбота факт и степен на увереност:
Кажи ми в коя година и от кого е публикуван методът на обратното
разпространение на грешката. Посочи колко си сигурен в проценти
и дай линк към източник, който мога да отворя.
Очакван резултат: отговор с проценти и линк. Отворете линка и проверете. Според учебника „Deep Learning“ методът е популяризиран през 1986 г. от Румелхарт, Хинтън и Уилямс.
Ако не работи: ако линкът не се отваря или не казва това, което твърди чатботът, сте хванали точно грешката, за която говорихме. Процентът не е гаранция.
Кои са най-честите заблуди за невронните мрежи?
- „Мисли като човешки мозък.“ Учебникът „Deep Learning“ изрично пише, че невронните мрежи по принцип не са проектирани да бъдат реалистични модели на биологичната функция.
- „Колкото по-сигурна е, толкова по-права е.“ Пандата, обявена за гибон с 99,3% увереност, показва обратното.
- „Знае откъде знае.“ Моделът няма списък с източници в главата си. Има тегла. Ако чатботът цитира източник, проверете го.
- „Това е нещо ново.“ Перцептронът е показан през 1958 г. Новото е мащабът: данните, изчисленията и броят на слоевете.
- „Повече параметри винаги значи по-умен модел.“ Според Google BgGPT с 27 милиарда параметъра изпреварва на български модели със 70 милиарда.
Как да научите невронните мрежи по-сериозно?
Ако тази статия ви е отворила апетит, ето пет следващи стъпки, подредени от лесно към трудно.
- Играйте в Playground с цел. Изберете най-трудния набор от точки и опитайте да го решите с възможно най-малко неврони. Така ще усетите какво правят слоевете.
- Минете курса на Google. Machine Learning Crash Course е кратко практическо въведение в машинното обучение с упражнения, включително модул за невронните мрежи (Google for Developers).
- Прочетете записките на CS231n. Записките на курса на Станфорд са отворени онлайн и обясняват неврона, слоевете и обучението с формули и картинки (Stanford CS231n).
- Вземете учебника. „Deep Learning“ на Гудфелоу, Бенджио и Курвил е пълен онлайн и безплатно в HTML (deeplearningbook.org).
- Учете с поглед към работата. Повечето хора нямат нужда да строят невронни мрежи. Имат нужда да ги ползват добре. Затова направихме курса за комуникация с AI (нашата платформа): три нива на промптване върху реален бизнес казус. Как да изберете курс изобщо, включително чужд, сме подредили в курс по изкуствен интелект: как да изберете.
Често задавани въпроси
Какво е невронна мрежа с прости думи?+
Как работи невронната мрежа?+
Има ли невронната мрежа истински неврони?+
Каква е разликата между невронна мрежа и дълбоко обучение?+
Невронна мрежа ли е ChatGPT?+
Неврона мрежа, неврална мрежа или невронна мрежа?+
Кой е измислил невронната мрежа?+
Има ли българска невронна мрежа?+
Заключение: какво да запомните за невронната мрежа?
Невронната мрежа е мозък без нито един неврон. Тя е подредена купчина от числа, които се настройват сами, докато грешката стане малка. Вдъхновението идва от биологията, а устройството е чиста математика: умножение, събиране, активация и милиони малки поправки.
От това идват и силата, и слабостта ѝ. Една и съща идея разпознава лица, превежда и пише текстове. Същата идея може да обяви панда за гибон с 99,3% увереност и никой не може да каже точно защо.
Помнете три неща. Мрежата знае само това, което е видяла в данните. Увереността ѝ е число, а не доказателство. А историята на Розенблат показва, че идея, отписана от авторитети, може да се върне с Нобелова награда 55 години по-късно.
Ако искате да превърнете това разбиране в умение за работа, разгледайте всички наши видео курсове (нашата платформа), които се учат в свое темпо.
Допълнителни ресурси
- Кралската шведска академия на науките: Нобеловата награда за физика 2024
- Stanford CS231n: невронни мрежи, част 1
- Stanford CS231n: обратно разпространение
- Deep Learning, Гудфелоу, Бенджио и Курвил (MIT Press), глава 1
- Google Machine Learning Crash Course: невронни мрежи
- TensorFlow Playground: невронна мрежа в браузъра
- Cornell Chronicle: перцептронът на Франк Розенблат
- ImageNet Classification with Deep Convolutional Neural Networks (NeurIPS 2012)
- Explaining and Harnessing Adversarial Examples (arXiv)
- Robust Physical-World Attacks on Deep Learning Models (arXiv)
- Attention Is All You Need (arXiv)
- Language Models are Few-Shot Learners, GPT-3 (arXiv)
- Anthropic: как изглежда отвътре един езиков модел
- Google DeepMind: INSAIT и BgGPT
Допълнителните източници са посочени с връзки при съответните твърдения в текста.