Съдържание на статията
Накратко: Машинно обучение се нарича начинът, по който компютърът се учи на задача от примери, вместо човек да му пише правилата. Машината дава отговор, мери грешката си и се поправя. Затова научава и онова, което никой не е искал да ѝ покаже: в преглед на 62 проучвания с модели за COVID-19 нито един не се оказа годен за болница.
Ключови факти:
- Google определя машинното обучение като обучаване на софтуер, наречен модел, който прави полезни предсказания или създава съдържание от данни (Google for Developers)
- Думите „machine learning“ стоят в заглавието на статия на Артър Самюъл от юли 1959 г. за програма, която играе дама (IBM Journal of Research and Development)
- Преглед в Nature Machine Intelligence намира 2 212 проучвания с модели за COVID-19 по снимки на гръдния кош, разглежда подробно 62 и заключава, че нито един модел не е годен за клинична употреба (Nature Machine Intelligence)
- Част от тези модели се научават да разпознават деца, а не COVID-19, защото здравите примери в данните са детски снимки (MIT Technology Review)
- Amazon разпуска екипа на системата си за подбор, след като тя сама се научава да сваля оценката на автобиографии с думата „женски“ (Reuters)
- Моделът GraphCast прави прогноза за времето за десет дни напред за по-малко от минута и е по-точен от най-добрите оперативни системи при 90% от 1 380 показателя (Science)
- През 2025 г. 2,26% от фирмите в България с поне десет заети ползват машинно обучение за анализ на данни при 5,10% средно за ЕС (Евростат)
- Законът на ЕС за изкуствения интелект иска данните за обучение на високорисковите системи да са „достатъчно представителни“ и във възможно най-голяма степен без грешки (EUR-Lex, чл. 10)
Какво е машинно обучение?
Машинно обучение (на английски machine learning, накратко ML) е дял от изкуствения интелект, при който програмата се учи от примери. При обикновената програма правилата ги пише човек: „ако в писмото има тази дума, прати го в спам“. При машинното обучение човекът дава хиляди писма с етикет „спам“ или „не е спам“, а правилата намира машината.
Курсът на Google го казва с едно изречение. Машинното обучение е процесът, при който се обучава софтуер, наречен модел, за да прави полезни предсказания или да създава съдържание от данни (Google for Developers). Моделът е математическа зависимост, извлечена от данните, която никой не е писал на ръка.
Най-известното определение е на Том Мичъл от 1997 г. Учебникът „Deep Learning“ го привежда дословно (Deep Learning, глава 5):
„За една компютърна програма се казва, че се учи от опита E по отношение на клас задачи T и мярка за успех P, ако представянето ѝ в задачите от T, измерено с P, се подобрява с опита E.“ Том Мичъл, 1997 г., цитиран в учебника „Deep Learning“ на Иън Гудфелоу, Йошуа Бенджио и Арън Курвил
С по-прости думи: има задача, има начин да се измери колко добре е свършена и има опит, от който резултатът става по-добър. Ако едно от трите липсва, машината не се учи.
Идеята е по-стара, отколкото изглежда. През юли 1959 г. Артър Самюъл публикува в списанието на IBM статията „Some Studies in Machine Learning Using the Game of Checkers“, тоест изследвания на машинното обучение върху играта дама (IBM Journal of Research and Development).
Каква е разликата между машинно обучение и изкуствен интелект?
Изкуственият интелект е целта: машина, която върши работа, за която обикновено е нужен човешки ум. Машинното обучение е един от пътищата дотам. Програма с правила, писани на ръка, също може да мине за изкуствен интелект, но тя не се учи от данни и затова не е машинно обучение.
Чатботовете, които познавате, вървят по този път. Google нарежда генеративния AI сред видовете машинно обучение (Google for Developers). През 2024 г. Кралската шведска академия на науките даде Нобеловата награда за физика на Джон Хопфийлд и Джефри Хинтън за открития и изобретения, които правят възможно машинното обучение с изкуствени невронни мрежи (NobelPrize.org).
Подредени от широко към тясно, четирите понятия изглеждат така:
- Изкуствен интелект: целта. Машина, която решава задачи.
- Машинно обучение: методът. Машината се учи от данни.
- Дълбоко обучение: машинно обучение с невронни мрежи на много слоеве.
- Генеративен AI: модели, които създават текст, образи и звук, като ChatGPT, Claude и Gemini.
Изкуствения интелект и невронните мрежи сме разгледали отделно: какво е изкуствен интелект, обяснено без формули и невронна мрежа: какво е и как работи.
Как се учи машината?
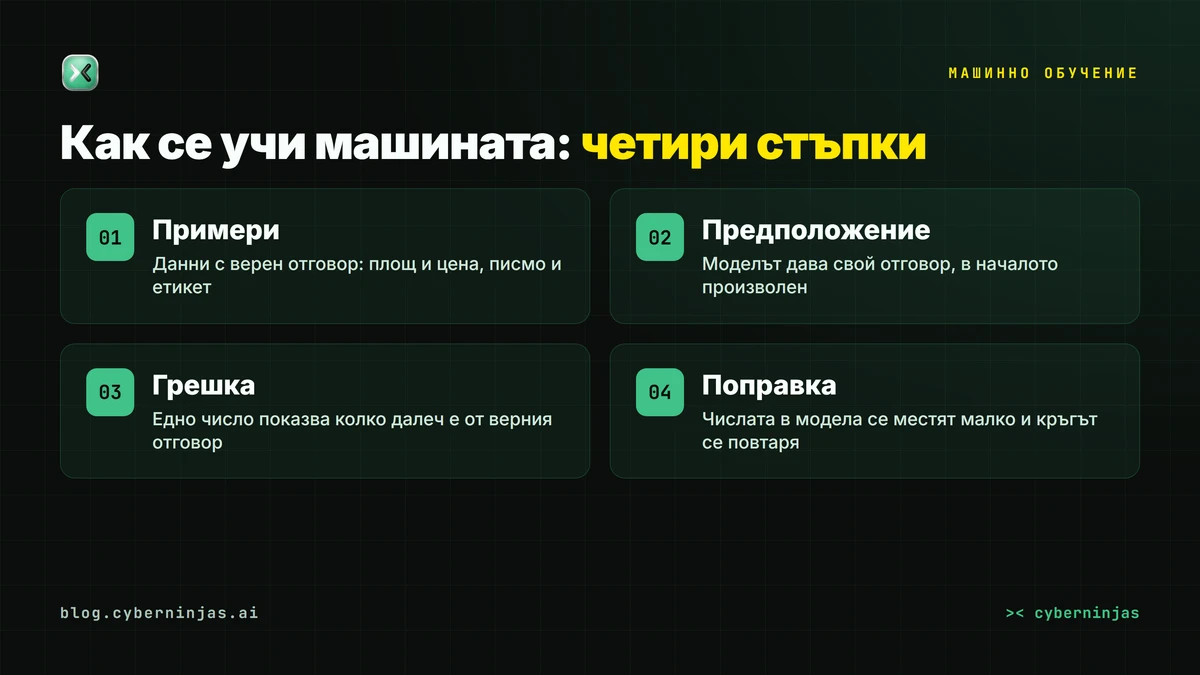
Машината се учи от грешките си и това е буквално описание на сметката, която прави. Стъпките са четири.
- Получава примери с верен отговор. Например площта на едно жилище и цената, на която е продадено.
- Дава свое предположение. В началото то е произволно.
- Мери грешката си. Google нарича това число загуба (loss). То описва колко грешни са предсказанията на модела, а целта на обучението е загубата да стане възможно най-малка (Google for Developers).
- Поправя се малко и повтаря. Числата вътре в модела се местят натам, накъдето грешката намалява.
Една поправка не променя почти нищо. Хиляди поправки превръщат произволните числа в модел, който познава.
Грешката стои и в името на най-известния метод за обучение на невронни мрежи. През октомври 1986 г. Дейвид Румелхарт, Джефри Хинтън и Роналд Уилямс публикуват в Nature статията „Learning representations by back-propagating errors“, тоест учене чрез връщане на грешките назад (Nature). Как става това в една мрежа, обясняваме в статията за невронните мрежи.
Остава един въпрос: научила ли е машината задачата, или само е запомнила отговорите. Затова част от примерите се скриват и се пазят за изпит. Google описва провала на този изпит с думата overfitting, на български преобучаване: моделът пасва на обучителните данни толкова плътно, че греши при нови данни (Google for Developers). Курсът го сравнява с изобретение, което работи добре в лабораторията и е безполезно в реалния свят.
Какви видове машинно обучение има?
Google дели системите с машинно обучение на четири вида според това как се учат. Една система може да попада в повече от един вид (Google for Developers).
| Вид | Как се учи | Пример |
|---|---|---|
| Обучение с учител | Вижда много примери с верния отговор, като ученик със стари изпити | Спам филтър, цена на жилище |
| Обучение без учител | Търси групи в данни без етикети; какво значи всяка група, решава човек | Данни за времето, групирани по сезони |
| Обучение с подкрепление | Действа и получава награда или наказание за всяко действие | Робот, който се учи да ходи; AlphaGo |
| Генеративен AI | Учи закономерностите в готово съдържание и създава ново | ChatGPT, Gemini, генератори на образи |
Обучението с учител решава две големи задачи. При класификацията моделът казва към коя категория спада нещо, например „спам“ или „не е спам“. При регресията предсказва число, например цена или киловатчасове (Google for Developers).
При обучението без учител никой не е казал на модела кои са групите. Той ги открива сам, а човекът решава какво означават. При обучението с подкрепление няма готови отговори, има награди и наказания. Така се обучават роботи да ходят и програми като AlphaGo да играят го.
Къде срещате машинно обучение всеки ден?
По-често, отколкото предполагате. Google изброява какво прави машинното обучение днес: предсказва времето, изчислява колко ще трае пътуването, препоръчва песни, довършва изреченията ви, обобщава статии и създава изображения, които не са съществували (Google for Developers).
Два примера показват докъде стига.
Прогнозата за времето. През 2023 г. екип на Google DeepMind описва в списание Science модела GraphCast. Той е обучен върху данни за времето от минали години и прави прогноза за десет дни напред за по-малко от минута. Според авторите GraphCast е по-точен от най-добрите оперативни системи при 90% от 1 380 проверени показателя (Science).
Белтъците. Половината от Нобеловата награда за химия за 2024 г. отиде при Демис Хасабис и Джон Джъмпър от Google DeepMind за предсказване на структурата на белтъците. С модела AlphaFold2 те успяват да предскажат структурата на почти всички 200 милиона белтъка, които изследователите са открили (NobelPrize.org).
В медицината същият подход вече помага при четенето на снимки. Какво е доказано там и какво още не е, сме описали в AI в медицината.
Какво става, когато машинното обучение научи грешния урок?
Машината знае едно: грешката трябва да намалее. Каква е истинската задача, тя не разбира. Ако в данните има пряк път към по-малка грешка, машината го намира.
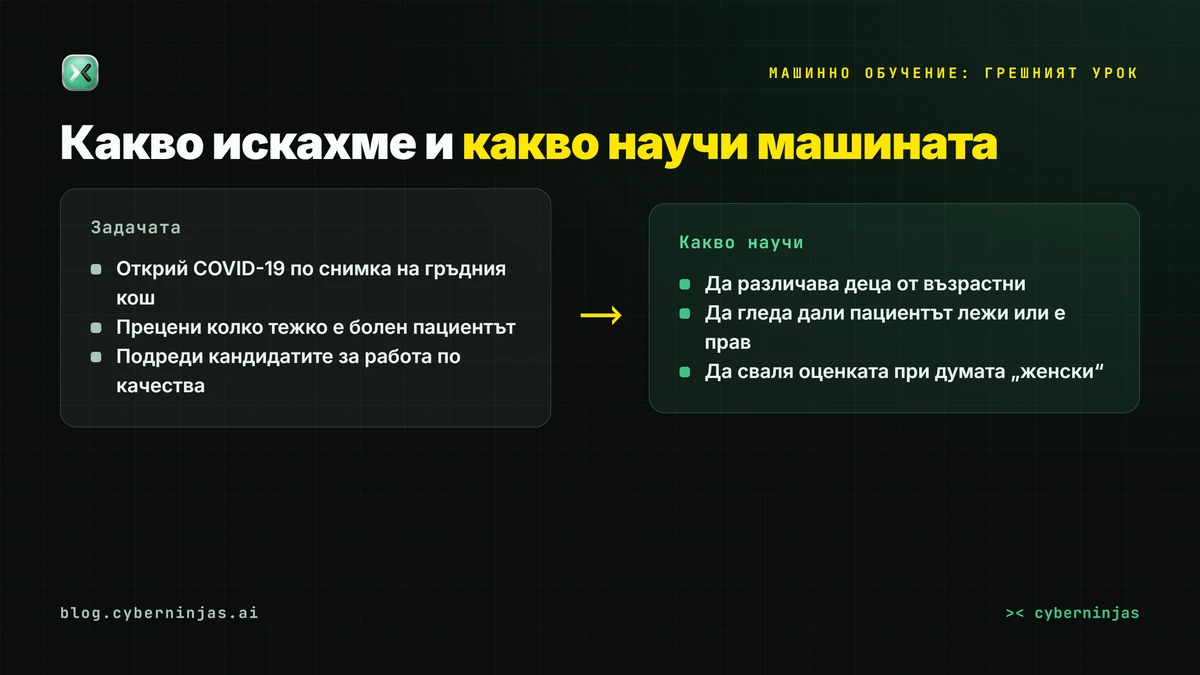
Моделите за COVID-19. През 2020 г. много екипи обучават модели, които да откриват COVID-19 по рентгенови снимки и скенер на гръдния кош. Преглед в Nature Machine Intelligence намира 2 212 такива проучвания, оставя 415 след първото пресяване и разглежда подробно 62. Заключението е, че нито един от моделите не е годен за клинична употреба заради методологични слабости и изкривявания в данните (Nature Machine Intelligence).
MIT Technology Review описва какво са научили част от моделите (MIT Technology Review):
- Деца вместо болест: много екипи, без да подозират, ползват за здрави примери набор от снимки на деца. Моделите се научават да разпознават деца, а не COVID-19.
- Поза вместо болест: в един набор част от пациентите са снимани легнали, а част прави. Легналите по-често са тежко болни и моделът започва да предсказва риска по позата.
- Шрифт вместо болест: някои модели се хващат за шрифта, с който болницата надписва снимките. Шрифтовете на болниците с по-тежки случаи се превръщат в признак за риск.
„Тази пандемия беше голям изпит за изкуствения интелект и медицината... Но не мисля, че го издържахме.“ Дерек Дригс, изследовател по машинно обучение в Кеймбриджкия университет, пред MIT Technology Review
Вторият голям преглед, в British Medical Journal, стига до същото. Екипът на епидемиоложката Лауре Винантс (Laure Wynants) от Маастрихтския университет преглежда 232 алгоритъма и не намира нито един годен за клинична употреба. Само два са отделени като достатъчно обещаващи за бъдещи тестове (MIT Technology Review).
Подборът в Amazon. На 10 октомври 2018 г. Reuters разказва за система, която Amazon строи от 2014 г., за да подрежда автобиографиите на кандидатите с оценка от една до пет звезди. Моделите са обучени върху автобиографии, пращани на компанията в продължение на десет години, а повечето са от мъже. Системата сама се научава, че мъжете са за предпочитане. Тя сваля оценката на автобиографии с думата „женски“, например „капитан на женския шахматен клуб“, и на завършилите два изцяло женски колежа (Reuters).
Инженерите поправят тези две неща. Според източниците на Reuters обаче няма гаранция, че машината не би намерила друг начин да подрежда хората несправедливо. До началото на 2017 г. екипът е разпуснат, а Amazon заявява пред агенцията, че инструментът „никога не е ползван от специалистите по подбор на Amazon за оценка на кандидати“.
И в двата случая никой не е написал лошо правило. Машината е направила точно това, за което е обучена: намалила е грешката върху данните, които е получила. Как подобни системи четат автобиографиите днес, проверихме в AI CV: автобиография, която минава филтрите.
- ✓Учи се от примери, без някой да пише правилата ред по ред
- ✓Прави прогноза за времето за десет дни напред за под минута (GraphCast)
- ✓Предсказа структурата на почти всички 200 милиона познати белтъка (AlphaFold2)
- ✓Може да се пробва в браузъра, без код и без опит (Teachable Machine)
- ×Учи и грешките в данните: системата на Amazon сваляше оценката при думата женски
- ×Хваща преки пътища: модели за COVID-19 разпознаваха деца, пози и шрифтове
- ×Добрият резултат на теста още не значи, че моделът работи в реалния свят
- ×Разбиране на задачата няма, има число на грешката, което трябва да намалее
Какво казва законът за данните, от които учи машината?
Европейският закон за изкуствения интелект, Регламент (ЕС) 2024/1689, има отделен член за данните, с които се обучават високорисковите системи. Член 10, алинея 3 гласи:
„Наборите от обучителни, валидационни и изпитвателни данни трябва да са подходящи, достатъчно представителни и във възможно най-голяма степен без грешки и пълни с оглед на предназначението на системата.“ Регламент (ЕС) 2024/1689, чл. 10, ал. 3
Същият член иска мерки за откриване, предотвратяване и смекчаване на предубедеността в данните (EUR-Lex). Цифровият омнибус за изкуствения интелект промени други алинеи на този член: първа, пета и шеста. Сверихме алинея 3 с консолидираната версия на регламента към 27 юли 2026 г. и тя е същата (AI Act Service Desk).
Кои системи са високорискови, казва Приложение III. Там са системите за набиране или подбор на хора, включително за анализиране или отсяване на молби за работа и за оценяване на кандидатите. Система като тази на Amazon попада точно в този списък. Какво предвижда българският проект, сме описали в закон за изкуствения интелект: какво забранява.
За вас като купувач това се свежда до три въпроса към всеки, който ви продава „AI“:
- Върху какви данни е учен моделът и приличат ли те на вашите клиенти, пациенти или документи?
- Как е проверен: върху примери, които не е виждал, и от кого?
- Кой отговаря, когато сгреши?
Ползват ли българските фирми машинно обучение?
Малко. Евростат пита фирмите в ЕС дали ползват машинно обучение за анализ на данни. През 2025 г. с „да“ отговарят 2,26% от фирмите в България с поне десет заети при 5,10% средно за ЕС (Евростат).
Изтеглихме данните за всички държави членки на 10 ноември 2026 г. и ги подредихме. България е на 26-о място от 27, пред Полша с 1,83%. Начело са Финландия с 12,85% и Дания с 12,75%.
Посоката все пак е нагоре. През 2021 и 2023 г. делът у нас е 0,94%, през 2024 г. е 2,11%, а през 2025 г. е 2,26%. Средното за ЕС за същото време расте от 2,44% на 5,10%.
Това е само един от редовете в изследването. Поне една AI технология ползват 8,55% от фирмите у нас при 19,95% в ЕС. Създаването на текст, реч или код с AI се брои отделно: 3,22% у нас при 8,76% в ЕС.
Кои български компании и институти работят с тези технологии, сме подредили в AI компании в България.
Какво ви трябва, за да пробвате машинно обучение?
- Браузър: двете стъпки без код работят направо в него.
- Python 3 или онлайн среда за Python: трябва за трите стъпки с код. Ние ползвахме Python 3.12.
- Около 30 минути.
- Математика до умножение: формули няма.
- Чатбот по ваш избор за последната стъпка: ChatGPT, Claude, Gemini или BgGPT.
Как да пробвате машинно обучение сами стъпка по стъпка?
Стъпка 1: Пуснете модел, който се учи от грешките си
Какво правим: обучаваме най-простия възможен модел да познава цената на жилище по площта.
Как: копирайте кода в Python 3 или в онлайн среда за Python и го пуснете. Числата в примера са измислени.
# Машината учи цена на квадратен метър от четири примера.
# Числата са измислени: площ в кв. м, цена в хиляди евро.
homes = [(50, 105), (60, 118), (80, 165), (100, 195)]

w = 0.0       # предположение за цената на 1 кв. м
lr = 0.00005  # колко силно се поправя след грешка

for step in range(1, 7):
    total_error = 0.0
    for area, price in homes:
        guess = w * area         # предсказание
        error = price - guess    # грешка
        w += lr * error * area   # поправка според грешката
        total_error += abs(error)
    print("Кръг", step, "грешка:", round(total_error, 1),
          "цена на кв. м:", round(w, 3))

print("Жилище от 70 кв. м:", round(w * 70, 1), "хил. евро")
Очакван резултат: пуснахме кода на 10 ноември 2026 г. с Python 3.12. В първия кръг общата грешка е 417,0, а в шестия е 19,8. Моделът стига до 1,982 хил. евро за квадратен метър и оценява жилище от 70 кв. м на 138,7 хил. евро. Грешката не пада до нула, защото четирите примера не лежат на една права линия.
Ако не работи: ако Python спре с грешка за кодировка (UnicodeEncodeError), сменете българските думи в редовете с print с латински. Сметките остават същите.
Стъпка 2: Развалете един пример
Какво правим: проверяваме какво научава машината от грешка в данните.
Как: добавете една нула към цената на второто жилище, сякаш някой е сбъркал при въвеждането. Сменете само този ред и пуснете кода пак.
homes = [(50, 105), (60, 1180), (80, 165), (100, 195)]
Очакван резултат: при нас цената на квадратен метър скочи от 1,982 на 3,414 хил. евро. Оценката за жилището от 70 кв. м стана 239,0 хил. евро вместо 138,7. Машината прие сгрешения ред за истина и го научи.
Ако не работи: проверете дали сте сменили само едно число. Скобите и запетаите остават същите.
Стъпка 3: Изпитайте модела върху жилище, което не е виждал
Какво правим: скриваме един пример и го пазим за изпит.
Как: пуснете този вариант. Моделът учи от три жилища, а четвъртото вижда чак накрая.
train = [(50, 105), (60, 118), (80, 165)]
test = (100, 195)  # жилище, което машината не е виждала

w = 0.0
lr = 0.00005

for step in range(1, 7):
    for area, price in train:
        error = price - w * area
        w += lr * error * area

guess = w * test[0]
print("Цена на кв. м:", round(w, 3))
print("Предсказание за 100 кв. м:", round(guess, 1))
print("Истинска цена:", test[1],
      "разлика:", round(test[1] - guess, 1))
Очакван резултат: при нас моделът предсказа 201,7 хил. евро за жилище, което струва 195. Разликата от 6,7 хил. евро е истинската му грешка, защото е измерена върху пример извън обучението.
Ако не работи: ако разликата излезе нула, най-вероятно тестовото жилище е останало и в списъка train.
Стъпка 4: Обучете модел с камерата, без код
Какво правим: обучаваме модел да различава два предмета.
Как: отворете Teachable Machine на Google. Сайтът обучава компютъра да разпознава ваши снимки, звуци и пози, без да иска опит или програмиране. Изберете проект с изображения и подайте по няколко десетки снимки на всеки от двата предмета, от файлове или от камерата. Пуснете обучението и покажете на модела нова снимка.
Очакван резултат: моделът казва кой от двата предмета вижда.
Ако не работи: снимайте предметите на различен фон и при различна светлина. Ако всички снимки на чашата са правени до прозореца, проверете дали моделът не е научил прозореца вместо чашата. Така ще видите в малък мащаб какво се случи с моделите за COVID-19.
Стъпка 5: Накарайте чатбота да ви изпита
Какво правим: проверяваме дали разпознаваме грешка в данните.
Как: поставете това в ChatGPT, Claude, Gemini или BgGPT:
Ти си преподавател по машинно обучение.
Дай ми три кратки измислени случая, в които
модел е научил грешното нещо от данните си.
След всеки случай ме питай къде е грешката
в данните. Не ми казвай отговора, преди да
съм опитал. Накрая кажи колко съм познал.
Очакван резултат: три кратки задачи, в които сами намирате прекия път, по който е тръгнал моделът.
Ако не работи: ако чатботът издаде отговорите веднага, напишете му „Само първия случай, без отговора“.
Кои книги за машинно обучение си струват?
Започнете от безплатните. Три учебника се четат законно и без пари в интернет, и трите на английски.
- „Mathematics for Machine Learning“ на Marc Peter Deisenroth, A. Aldo Faisal и Cheng Soon Ong, издадена от Cambridge University Press през 2020 г. Авторите обещават да държат PDF версията свободно достъпна (mml-book.github.io). Учебникът покрива математиката, върху която стъпва всичко останало: линейна алгебра, вероятности и оптимизация.
- „Deep Learning“ на Иън Гудфелоу, Йошуа Бенджио и Арън Курвил, издадена от MIT Press. Онлайн версията е пълна и остава безплатна (deeplearningbook.org). Глава 5 е въведение в машинното обучение.
- „Dive into Deep Learning“ е интерактивна книга с код, формули и дискусии. Според сайта ѝ я ползват 500 университета в 70 държави (d2l.ai).
В търсенето си за тази статия не намерихме учебник по машинно обучение, преведен на български. За първи стъпки на роден език остават курсовете.
- Elements of AI е безплатен онлайн курс за основите на изкуствения интелект с версия на български. Разработен е от MinnaLearn и Хелзинкския университет. Сайтът сам предупреждава, че най-новата версия е английската (Elements of AI).
- Machine Learning Crash Course на Google е практическо въведение с видеа, интерактивни визуализации и упражнения. По думите на Google от 2018 г. насам го ползват милиони хора. На 10 ноември 2026 г. в менюто с езиците му няма български (Google for Developers).
Ако целта ви е да работите добре с готовите модели, без да строите свои, за това са нашите видео курсове (нашата платформа). Как да постигаме най-добри резултати в комуникацията си с AI минава през три нива на промптване върху реален бизнес казус. Как да работим с изкуствен интелект в компютъра си показва стъпка по стъпка как се изгражда локална AI среда, която вижда файловете ви. Как да изберете курс изобщо, включително чужд, сме описали в курс по изкуствен интелект: как да изберете.
Машинно обучение: кои са най-честите заблуди?
- „Машината разбира задачата.“ Тя намалява едно число, загубата. Моделите за COVID-19 намалиха грешката си, като се научиха да познават деца.
- „Повече данни значи по-добър модел.“ Amazon имаше автобиографии за десет години. От тях моделът научи, че мъжете са за предпочитане.
- „Висок резултат на теста значи, че работи.“ MIT Technology Review описва набори от данни, сглобени от няколко източника, в които едни и същи снимки попадат и в обучението, и в теста. Така моделите изглеждат по-точни, отколкото са.
- „Машинното обучение е само за програмисти.“ Teachable Machine на Google обучава модел в браузъра без опит и без код.
- „Това е нова мода.“ Статията на Самюъл с „machine learning“ в заглавието е от 1959 г.
Често задавани въпроси
Какво е машинно обучение с прости думи?+
Каква е разликата между машинно обучение и изкуствен интелект?+
Как се учи машината?+
Какви видове машинно обучение има?+
ChatGPT машинно обучение ли е?+
Може ли машинното обучение да греши?+
Трябва ли да знам програмиране, за да уча машинно обучение?+
Кои книги за машинно обучение са безплатни?+
Ползват ли българските фирми машинно обучение?+
Заключение: какво да запомните за машинното обучение?
Машинното обучение е учене от примери и от грешки. Машината дава отговор, мери колко е сбъркала и се поправя, докато числото на грешката стане малко. Същият механизъм прави прогноза за времето за под минута и подрежда автобиографии.
От него идва и слабото място. Машината учи това, което е в данните, включително нашите грешки и случайните съвпадения. Моделите за COVID-19 научиха деца, пози и шрифтове, а системата на Amazon научи, че мъжете са за предпочитане.
Запомнете трите въпроса за всеки продукт с „AI“ в името: върху какви данни е учен, как е проверен и кой отговаря, когато сгреши. Ако искате да работите уверено с готовите модели, разгледайте всички наши видео курсове (нашата платформа), които се учат в свое темпо.
Допълнителни ресурси
- Google for Developers: какво е машинно обучение
- Google Machine Learning Crash Course: загуба
- Google Machine Learning Crash Course: преобучаване
- Deep Learning, Гудфелоу, Бенджио и Курвил (MIT Press), глава 5
- Some Studies in Machine Learning Using the Game of Checkers (IBM Journal, 1959)
- Learning representations by back-propagating errors (Nature, 1986)
- Common pitfalls and recommendations for using machine learning to detect and prognosticate for COVID-19 (Nature Machine Intelligence, 2021)
- MIT Technology Review: стотици AI инструменти срещу COVID-19, нито един не помогна
- Reuters: Amazon спира тайна AI система за подбор
- Learning skillful medium-range global weather forecasting, GraphCast (Science, 2023)
- Нобелова награда за химия 2024: прессъобщение
- Нобелова награда за физика 2024: прессъобщение
- Регламент (ЕС) 2024/1689, текст на български (EUR-Lex)
- AI Act Service Desk: член 10, данни и управление на данните
- Евростат: изкуствен интелект във фирмите (isoc_eb_ai)
- Teachable Machine на Google
- Elements of AI на български
Допълнителните източници са посочени с връзки при съответните твърдения в текста.